课题组学术周会汇报 · 分布式系统与微秒网络调度

同机架微秒级 RPC 调度:绑定时机与跨机纠偏的权衡与发现

显式成本口径下的相图规律、延迟反例与系统资源可行性边界
核心研究关切
在任务执行仅数微秒(1 ~ 10 μs)的高并发数据中心环境中,通信时延与计算耗时已处于同一数量级。
请求究竟应当在何时绑定到执行核心?在真实通信与控制开销约束下,事后跨机纠偏与工作窃取是否真正划算?

1. 显式建模与解析对齐

全链路纳秒级显式计费,E0 阶段与经典排队论数学解析解实现 100% 置信区间对齐,奠定基准可信度。

2. 相图规律与时延反例

揭示入口晚绑定主导性;多核池化大幅压缩跨机空间;发现 31 组纠偏组合因时延增大率先失效反噬。

3. 系统瓶颈与资源红线

刻画软件网关 CPU 满载雪崩断崖;在 20% 算力预算下完成可行域筛选,79.2% 纠偏配置无可行解。

1. 研究背景与核心矛盾:微秒级系统的现实挑战 Problem Formulation & Explicit Cost Dimensions

现实挑战一:极短任务 vs 不可忽视的通信耗时

  • 任务纯执行极短:现代内存 KV(RocksDB / Redis)单次 RPC 计算执行仅 s = 1 ~ 10 μs。
  • 网络传输开销显著:高速网卡单程时延 D ≈ 4.5 μs,往返 RTT 实测达 8 ~ 10 μs。
  • 数量级完全对齐:通信调度开销与任务纯执行时间处于同一微秒数量级。
  • 传统宏观假设失效:宏观调度中“开销可忽略”的假设在微秒尺度下彻底不成立。

现实挑战二:微突发击穿与尾延迟敏感性

  • 微突发 (Micro-bursts):到达变异系数 CV = 1.0 ~ 2.5,局部短时形成瞬时排队积压。
  • 严苛尾延迟约束:99% 尾延迟通常要求 ≤ 50 μs,单次跨机排队阻塞即可直接引发违约。
微突发到达 (CV=2.5)
→
局部瞬时排队
→
跨机通信惩罚 (8μs)
→
尾延迟突破 50μs 门限
核心矛盾小结:微秒尺度下不存在“免费调度”,任何跨机通信与控制动作均伴随昂贵物理耗时,必须显式计费。
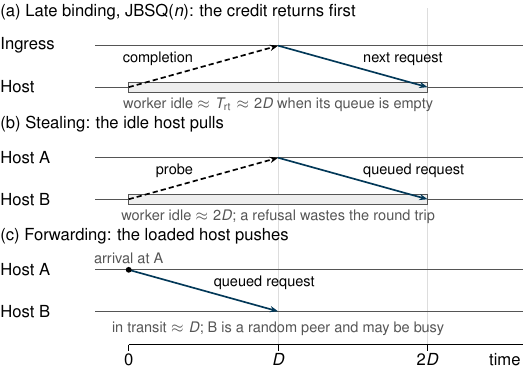
Critical Paths
图 1: 关键路径通信时延时序(晚绑定 Pull ≈ 2D, 纠偏 Forwarding ≈ 2D, 本地共享 ≤ 100ns)
关键路径物理时延关系:

Formula: Critical Paths

2. 学术争论与研究理念:两大流派的同口径对决 Taxonomy of RPC Schedulers & Research Philosophy

流派一:入口晚绑定 (Late Binding / Centralized Pull)

  • 代表工作:R2P2 (ATC'19), Draconis (EuroSys'24), JIQ, JBSQ
  • 调度机制:请求在网关暂存,Worker 空闲时通过 Credit / Pull 主动按需拉取。
  • 核心优势:源头消除排队失衡,不盲目向节点堆积请求,天然实现近似 FIFO。
  • 主要代价:需经历初始往返等待;高度依赖可编程硬件(P4/SmartNIC)或集中网关。

流派二:早绑定 + 跨机纠偏 (Early Binding + Movement)

  • 代表工作:Capybara (SIGCOMM'26), ZygOS (SOSP'17), SBB (OSDI'26)
  • 调度机制:到达时哈希直接绑定;排队失衡时通过工作窃取、盲推或连接迁移重调度。
  • 核心优势:天然适配长连接与连接亲和(gRPC/TCP),无需可编程网络硬件。
  • 主要代价:跨机搬迁需二次网络传输;高并发下存在状态陈旧与反复踩踏风险。
两大流派执行时序工作流对比:
请求到达
→
Credit 触发
→
单次下发执行 (无二次搬迁)
首发哈希
→
节点队列积压
→
二次网络移动 (时延 D)
本课题研究理念:脱离两派各自理想化假设,在统一纳秒级显式成本模型下,跨越负载 ρ、时延比 D/s、核心数 m 与算力预算多维空间客观量化。
集群实验总规模 时延扫参范围 (D/s) 典型调度策略覆盖 全链路显式成本计费
128 核 (单机 1~16 核) 150 ns ~ 6 μs 9 种典型策略 (入口/晚绑/纠偏) 头部 / 载荷 / 控制核 / 核间原子操作

3. 研究方法与基准验证 (E0 Validation):底层模型解析校验 Simulation Methodology, Cost Model & Analytical Ground Truth

RPC 生成 (Exp/Bimodal)
→
NIC TX (64B: 20ns / 256B: 82ns)
→
ToR 交换传播 (单向 D)
→
Host 调度 (200~500ns)
→
核间同步 (100ns)
→
Worker 计算 (1~10μs)

全链路显式成本参数矩阵 (Table I)

系统要素配置参数物理意义与工程对应
报文头传输64B / 25Gbps = 20.48 ns控制报文网卡串行化耗时
载荷数据传输256B / 25Gbps = 81.92 ns数据报文网卡串行化耗时
核间通信窃取原子操作 = 100 ns单机 L3 Cache / CAS 开销
控制核调度处理网关调度 = 200 ~ 500 ns软件网关单请求决策耗时
交换机单向时延D = 150 ns ~ 4.5 μs同机架转发与光纤传播
非预知原则 (Non-clairvoyant):策略严格基于到达报文与本地状态决策,禁止窥探任务未来真实执行时间。

E0 理论解析解基准校验结果 (Table II)

理论参考模型测试单元最大相对误差99%理论区间覆盖
M/M/k 闭式解120.19%12 / 12 (100%)
M/G/1 (P-K 公式)43.62%4 / 4 (100%)
M/H₂/k 矩阵几何解40.74%4 / 4 (100%)
独立 Python 仿真复核41.21 SE4 / 4 (100%)
注:测试值全部落入 99% 置信区间;两套独立仿真代码完全对齐,底层排队引擎实现零偏差。
E0 数学解析校验机制:经典排队论数学闭式解 (M/M/k, M/G/1, M/H2/k) ↔ C++17 rpcsim 离散事件引擎 ↔ Python 独立仿真验证器 (相同随机种子背靠背复核 1.21 SE)。

4. 核心发现一:绑定时机主导,强入口下纠偏空间有限 E1 Phase Diagram: Ingress vs Movement Interplay
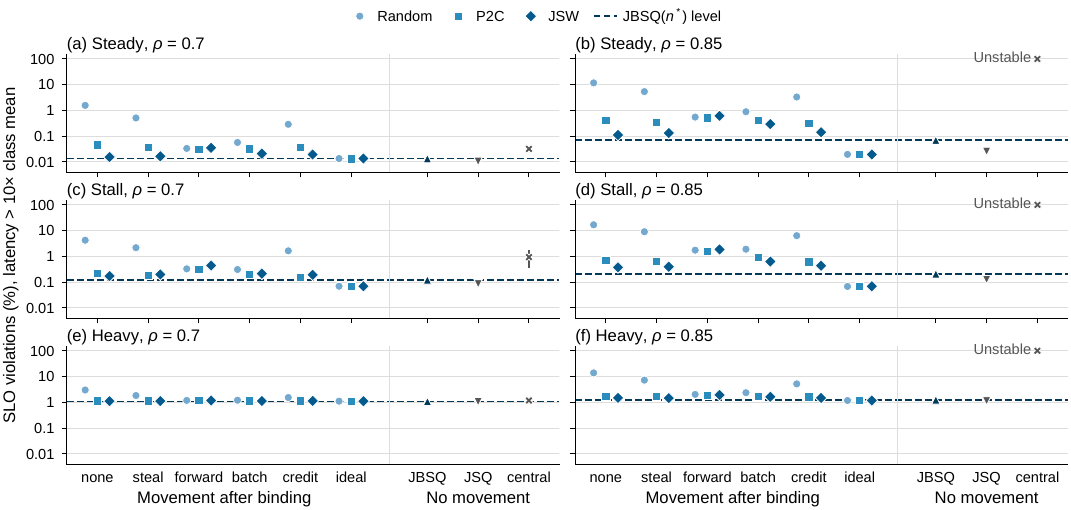
Figure 2: E1 Violations
图 2: 基准点(16×8核,ρ = 0.85)下各策略违约率分布箱线图

核心实验数据与规律观察

  • 弱入口下纠偏收益显著:在无状态 Random 入口下,跨机转发(Forwarding)可缩减与最优晚绑定之间 91% ~ 96% 的违约差距。
  • 强入口下纠偏收益递减:在带全局状态摘要的 JSW 入口后,任何跨机纠偏能挽回的残余差距不足一半 (< 50%)。
  • 高负载下晚绑定稳定:在稳态 85% 负载(ρ = 0.85)下,调优后的晚绑定 JBSQ 违约率持续优于非理想纠偏。
第一梯队:晚绑定 JBSQ / JIQ (违约率 ~4.1%)
→
第二梯队:强入口 JSW / 纠偏 (10% ~ 15%)
→
第三梯队:随机哈希 (>35%)

机制消融实验:提货券时效性 (TTL Ablation)

移除 Credit 的有效时限(TTL)后,违约率在 12 个 Random 与 11 个 P2C 单元全部显著恶化。
微秒高并发下状态极其快速陈旧,过期凭证诱发严重羊群效应(Herd Effect);时效性保证是晚绑定机制平稳运行的必要前提。

本页小结:绑定时机在排队决策中占决定性主导地位。 优质入口调度(如 JSW)从源头消除了绝大部分失衡;依赖事后跨机移动,在强入口下由于网络往返惩罚,边际改善空间极其受限。

5. 核心发现二:单机多核池化对跨机纠偏的挤压效应 E2 Intra-Host Pooling Squeezes Movement Headroom

实验设定:机架总核心固定为 128 核,稳态高负载 ρ = 0.85。
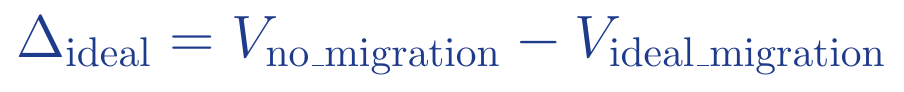
理想迁移降低量定义: Formula: Delta Ideal
单机核数 m (主机数 N) Random 入口降低 Δideal (pp) P2C 入口降低 Δideal (pp) JSW 入口降低 Δideal (pp) 纠偏空间特征分析
m = 1 (128 台主机) 58.44 [58.23, 58.68] 32.48 [32.32, 32.66] 10.85 [10.73, 10.97] 无本地多核缓冲,跨机迁移效益显著
m = 2 (64 台主机) 43.49 [43.28, 43.74] 14.34 [14.19, 14.50] 4.96 [4.89, 5.04] 收益开始出现大幅下跌
m = 4 (32 台主机) 27.20 [26.93, 27.50] 3.46 [3.41, 3.50] 1.22 [1.19, 1.25] 强入口下纠偏收益被压至 1% 附近
m = 8 (16 台主机) 11.71 [11.49, 11.89] 0.38 [0.36, 0.40] 0.09 [0.08, 0.10] 主流服务器基准:理论优化空间已不足 0.4 pp
m = 16 (8 台主机) 2.39 [2.16, 2.62] 0.03 [0.02, 0.04] 0.003 [0.002, 0.005] 纠偏空间趋近于零
微突发负载到达
→
本地多核池化吸收 (95%+)
→
跨机收益骤降 (<0.4pp)
→
边界刚需场景:Host Stall (整机停顿)

排队论机理:统计复用 (Statistical Multiplexing)

当单机核心 m ≥ 8 时,单机共享队列在本地自我消化了 95% 以上的瞬时失衡。本地多核共享仅需 100ns,而跨机搬迁需数微秒,多核池化大幅压缩了跨机纠偏的边际空间。

统计显著性与边界场景 (Host Stall)

严格单调性:48 对相邻核数比较全部单调下降(Holm-Bonferroni 校正 p ≤ 0.0048)。
主要刚需场景:仅在发生整机停顿(Host Stall / GC 停顿)本地核心全瘫痪时,跨机迁移才具备不可替代价值。

6. 核心发现三:延迟扫参反例——晚绑定具备更强时延鲁棒性 E3 Delay Sweep: Late Binding is More Delay-Robust
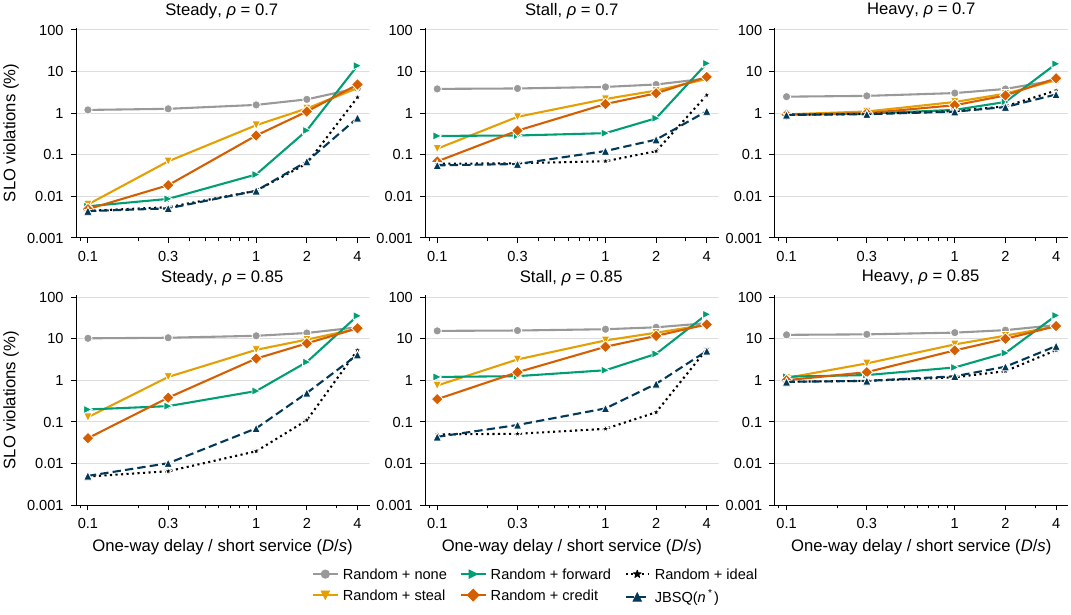
Figure 4: E3 Movement vs Delay
图 4: 随反馈时延增加,跨机纠偏迅速失效,JBSQ 持续领先

31 组纠偏组合率先失效反例

  • 扫参空间:时延比值 D/s ∈ [0.1, 4.0](网络单向时延达任务耗时 4 倍)。
  • 反常失效事实:31 个“早绑定 + 跨机纠偏”组合率先失效,丧失相对随机入口的优势(30 个在独立种子上稳定复现)。
  • 晚绑定表现:调优后的 JBSQ 在全时延范围内持续保持显著领先。

恶劣时延极端点数据对比 (ρ = 0.85, D/s = 4)

调度策略99% 违约率相对基线判定
随机基线 (无迁移)18.78%常规排队对照
跨机盲推 (Forwarding)35.47%严重踩踏,负收益反噬
晚绑定 JBSQ(n*=64)4.12%管道自适应平抑
晚绑定 (Little's Law):扩大在途配额 n* 填满管道 → 零排队堆积
vs
纠偏:每次搬迁经历单程 D → 滞后踩踏 (35.47%)
反例核心学术启示:直觉认为“反馈链路长则晚绑定脆弱”存在片面性;在显式排队模型下,晚绑定只需增大在途配额即可屏蔽网络延迟;跨机纠偏受制于二次物理传输,延迟越大负收益越剧烈。
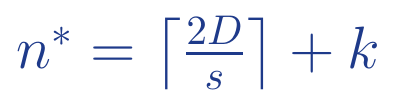
Formula: JBSQ Bound

7. 部署形态与系统开销边界:软件网关过载陡坡 T40b Deployment Overhead & Software Gateway Bottleneck

连接长尾偏斜对比 (Zipf α = 0.5,Table IV)

调度与纠偏策略违约率额外消息/RPC单机CPU开销
静态哈希 (无迁移基线)13.26%0.000200 ns
请求级 Credit 纠偏3.61%0.351340 ns
Capybara 主动连接迁移12.94%0.006204 ns
Capybara 被动连接迁移27.24%0.148323 ns

软件网关 CPU 算力饱和断崖效应 (Figure 5)

软件调度网关单消息处理耗时达到 200 ~ 500 ns 时,微秒高并发调度需要消耗专用核心:
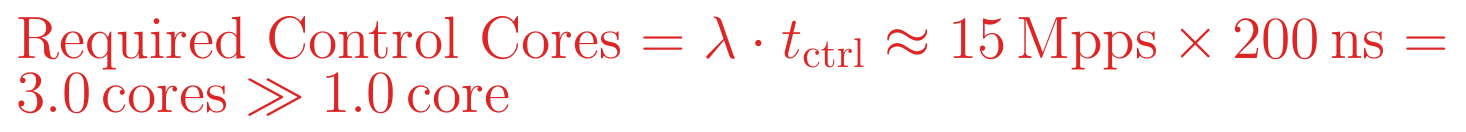
Formula: Gateway Collapse 若仅配置单控制核,在 ρ ≈ 0.65 处该核心发生 100% 满载饱和,违约率直接垂直跳变至 100%。

高并发流量 (15 Mpps)
→
网关处理延迟 (200~500ns)
→
需求 3.0 核 > 供给 1 核
→
网关雪崩 (100% 违约)
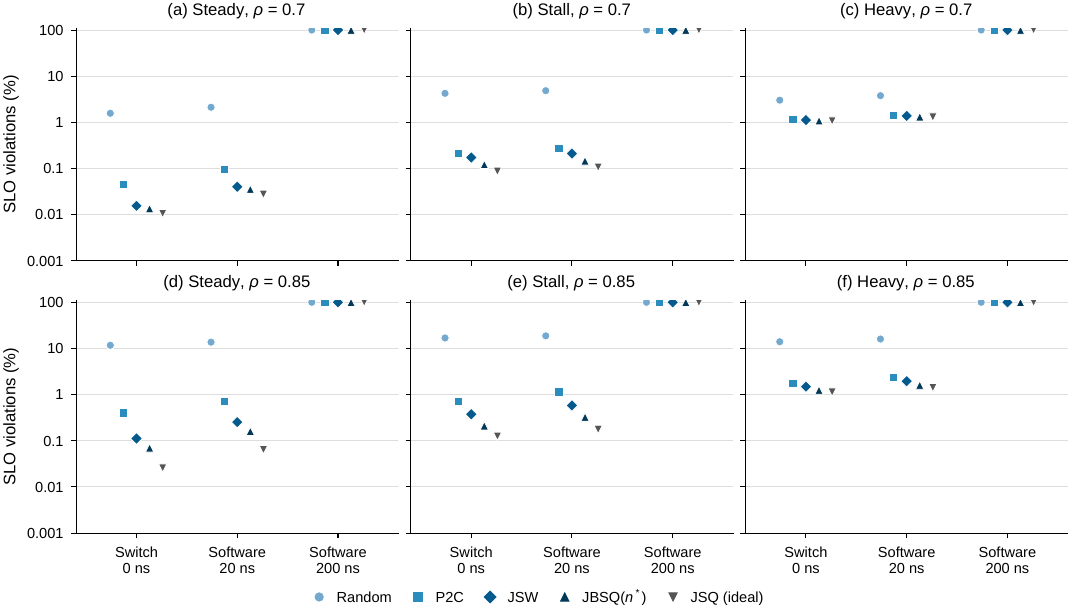
Figure 5: Software Ingress CPU Overload
图 5: 软件调度器过载导致违约率在 0.65 负载处垂直攀升至 100%
部署选型启示:集中式晚绑定必须依托可编程交换机 (P4 Switch) 或智能网卡 (SmartNIC) 硬件卸载;若采用纯软件集中网关,控制开销将成为系统主要瓶颈。

8. 严格资源预算下的纠偏可行性筛选 (T87 实验) T87 Resource-Constrained Frontier: Feasibility under Budgets

工业级约束设定:异构主机与混合流量下,限定额外控制 CPU 开销 ≤ 20%,端口带宽占用 ≤ 1%。
调度策略名称 评估集违约率 资源可行率 (12组) 重复实验违约率 重复可行率 (5组) 统计与工程判定
无迁移基线 (No migration) 27.81% 12 / 12 (100%) 24.20% 5 / 5 (100%) 无额外开销,完全满足预算
工作窃取 (Work stealing) 21.40% 12 / 12 (100%) 18.61% 5 / 5 (100%) 均值降低 6.4 pp,未过复合显著性
批量窃取 (Batch stealing) 21.23% 12 / 12 19.43% 3 / 5 (超标) 突发窃取导致端口带宽预算违规
知情转发 (Informed forwarding) 22.78% 12 / 12 20.51% 5 / 5 依赖周期性状态广播,收益有限
探针前推 (Probe forwarding) 24.65% 12 / 12 21.29% 5 / 5 探针命中率低,且占用额外 CPU
72 组候选配置
→
CPU 门槛 (≤20%) 淘汰 57 组 (79.2% 无解)
→
网络端口门槛 (≤1%) 淘汰批量窃取
→
复合统计检验严格汇报尾部方差

79.2% 配置因超标无可行解 (Infeasible)

在全量测试的 72 组配置组合中,多达 57 组配置因超出 20% CPU 预算而直接无可行解。微秒系统中,任何盲目的跨机探针与高频状态轮询,都是不可承受的算力负担。

统计检验严谨性体现

工作窃取虽在描述统计上降低了 6.408 pp,但因尾部种子波动未过复合假设检验。我们坚持如实汇报边界与客观统计,杜绝学术夸大。

9. 总结与后续研究计划 Summary, Architectural Trade-offs & Next Steps

1. 核心学术发现

  • 绑定时机占主导:强入口(JSW)后跨机纠偏空间不足一半;
  • 多核池化挤压:m ≥ 8 时纠偏理论空间已压缩至 < 0.4 pp;
  • 时延鲁棒反例:晚绑定依靠在途配额自适应优于早绑定纠偏;
  • 凭证时效性:消融证明 TTL 是晚绑定防范羊群效应的生命线。

2. 资源与开销边界

  • 网关算力断崖:软件集中网关在单核下直接打爆(100% 满载违约);
  • 硬件卸载必要:集中晚绑定必须依托 P4 交换机或 SmartNIC;
  • 资源预算筛选:79.2% 纠偏配置超出 20% CPU 预算;
  • 连接迁移局限:Capybara 在微秒 RPC 下粒度过粗,解耦缓慢。

3. 实验验证与后续规划

  • 物理测试床验证:搭建 100G RoCE / RDMA 物理集群开展硬件基准对照;
  • SmartNIC 硬件卸载:推进基于端网协同(Host-NIC Co-design)的网卡调度原型;
  • 跨机架长尾场景拓展:评估多级交换机(ToR-Spine)拓扑对调度时延的影响;
  • 混合异构负载适配:针对重尾分布探索动态自适应的在途配额流控算法。
同机架微秒级 RPC 调度工程架构选型决策指南:
有硬件 P4 / SmartNIC?
YES →
选用 晚绑定 (JBSQ / Credit) (源头消除失衡)
NO →
单机核心 m ≥ 8?
YES →
强入口 (JSW) + 本地核间池化 (无需跨机纠偏)
下一步工作计划:推进基于端网协同(Host-NIC Co-design)的网卡硬件卸载原型开发,并在真实 100G RoCE/RDMA 物理集群上进行基准对照测试。
← 回木屋笔记 回农场 1 / 10 快捷键:[←] [→] [空格] [F全屏]